軽量Embeddingモデルの可能性と現実:Gemma-300M vs CPU推論
lsh-cascade-poc プロジェクトでは、これまでスケーラブルな検索システムの構築を目指して様々な実験を行ってきました。
今回は、GitHubリポジトリの Notebooks 91番以降 で実施した、最新の 軽量Embeddingモデル に関する実験結果と、そこから得られた知見を共有します。
2026年に入り、Embeddingモデルのトレンドは大きく変化しています。
lsh-cascade-poc プロジェクトでは、これまでスケーラブルな検索システムの構築を目指して様々な実験を行ってきました。
今回は、GitHubリポジトリの Notebooks 91番以降 で実施した、最新の 軽量Embeddingモデル に関する実験結果と、そこから得られた知見を共有します。
2026年に入り、Embeddingモデルのトレンドは大きく変化しています。
これまでの実験では、テキストや画像の「ベクトル検索」によって、類似情報を高速に見つける技術を検証してきました。 しかし、ベクトル検索だけでは「AとBの関係は?」「前回の会議から何が変わった?」といった、構造や時間を伴う質問には弱いという課題がありました。
そこで新たに Graph RAG (Retrieval-Augmented Generation) の実験プロジェクトを立ち上げ、特に「時系列情報(Time)」をグラフに組み込むアプローチを検証しました。
前回 2026-02-13 での報告以降、Image Vector プロジェクトでは新たな可能性を探るためにいくつかの重要な実験を行いました。今回はその進捗と成果について共有します。
まず、顔認識(Face Recognition)の実装について検証を行いました。
結論として、現在のOSSモデルを利用した顔認識機能は 非常に高いレベル に達していることが確認できました。 CMSにおいて「誰が写っているか」を自動でタグ付けしたり、特定の人物の写真を瞬時に検索したりする機能の実装において、現在のモデルは十分実用的な性能を持っています。これにより、単なる「類似画像検索」だけでなく、「人物検索」という強力な軸をシステムに組み込む準備が整いました。
次に、アーキテクチャ面での大きな収穫です。ONNX Runtime と Transformers.js を用いた検証を行いました。
重要な発見は、Transformers.jsを使ったJSでの実装も十分に可能である という点です。具体的には、Python (PyTorch) で生成した画像ベクトルと、JavaScript (Transformers.js) で生成したテキスト検索クエリの埋め込みベクトルが完全な互換性を持つ ことが確認されました。
これは、重い画像処理やインデックス作成はサーバーサイド(Python)でバッチ処理しておき、ユーザーが検索窓に入力したキーワードのベクトル化は、サーバーを介さずにユーザーのブラウザ上(JavaScript)で完結させるという構成が可能であることを意味します。サーバー負荷を抑えつつ、高速な検索体験を提供できる可能性があります。
最後に、より高性能なモデルとして SigLIP 2 の検証を行いました。
検証の結果、SigLIP 2 は前モデルと比較しても明確に良くなっている ことが確認できました。特に画像のニュアンスを捉える能力や、多言語での検索精度において期待が持てます。これを ONNX 化して利用することで、推論速度とモデルサイズのバランスを取りながら、より高精度な検索システムを構築できる見込みです。
今回の実験を通じて、顔認識の実用性、クライアントサイドでの推論の可能性、そして最新モデルによる性能向上が確認できました。今後はこれらの要素を統合し、より高度な画像検索システムの構築を目指していきます。
数年前から取り組んでいた、Plone向けのベクトル(セマンティック)検索エンジンを、ついに collective.vectorsearch パッケージとしてリリースしました。
長らく構想段階や実験的な実装に留まっていましたが、いくつかの重要な要因が重なり、実用的なレベルまで作り込むことができました。
PyPIへのリリースはまだしていませんが、GitHubからソースコードを入手していただければ、すぐに利用を開始できます。
一度は停滞していたこのプロジェクトですが、以下の理由から「今ならできる」と確信し、開発を再スタートさせました。
LSH-cascade方式によるスケーラビリティの確保 大規模なデータセットに対しても現実的な速度とリソース使用量で動作する見込みが立ちました。特に、Pythonのみで完結するライブラリ群を活用することで、Ploneの既存スタックとの親和性を保ちながら実装できました。
多様な選択肢の確立 検索方式やEmbeddingモデル(埋め込みモデル)において、複数のアルゴリズムやモデルを柔軟に選択・切り替えられるアーキテクチャが見えてきました。これにより、CPUのみの環境からGPUを搭載した高性能サーバーまで幅広く対応可能になりました。
AIコーディングアシストによる開発加速 これが最も大きな要因の一つかもしれません。AIによる支援を受けることで、複雑なアルゴリズムの実装やテストコードの作成が飛躍的にスムーズになり、開発スピードが向上しました。
今回完成した collective.vectorsearch は、以下の特徴を持っています。
Ploneの標準的な検索機構である ZCatalog に、新しいインデックスタイプ VectorIndex を追加します。これにより、従来のテキスト検索や日付検索と組み合わせてベクトル検索を行うことが可能になります。
研究開発プロジェクト lsh-cascade-poc の成果を取り入れ、状況に応じて以下の検索方式を自動的に使い分けます。
デフォルトでは FastEmbed を採用しており、CPU環境でも高速に動作する量子化モデル (All-MiniLM-L6-v2, E5-Base Multilingual) をすぐに利用できます。また、GPU環境がある場合は [gpu] オプションを追加することで、PyTorchベースのモデルも利用可能です。
まずは基本的なベクトル検索機能を提供しましたが、今後はRAG(Retrieval-Augmented Generation)への応用や、リランキング機能の開発を続けていきます。リランキング機能は既存のキーワード検索との融合やコンテンツのライフサイクル管理なども考慮して開発しています。
ぜひ、GitHubリポジトリをチェックしてみてください。
Image Vector PoC プロジェクトの一環として、Gradioを使用したデモアプリを作成し、実際のデータを用いた検証を行っています。
今回作成したデモアプリでは、以下の主要な機能を実装しました。
モデルには、事前の実験で多言語対応において良好な結果を示した Google SigLIP を採用しています。
検証には、PyCon JP がFlickrで公開している3万枚を超える写真データを使用しました。
以下が、デモアプリのスクリーンショットです。
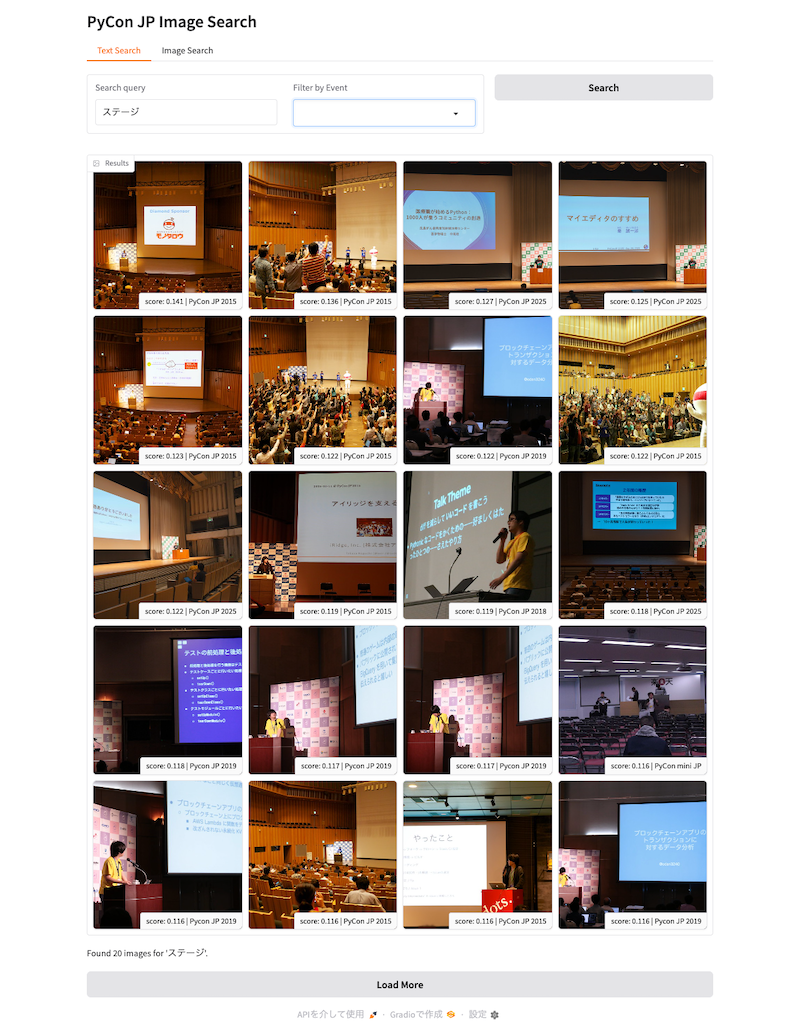
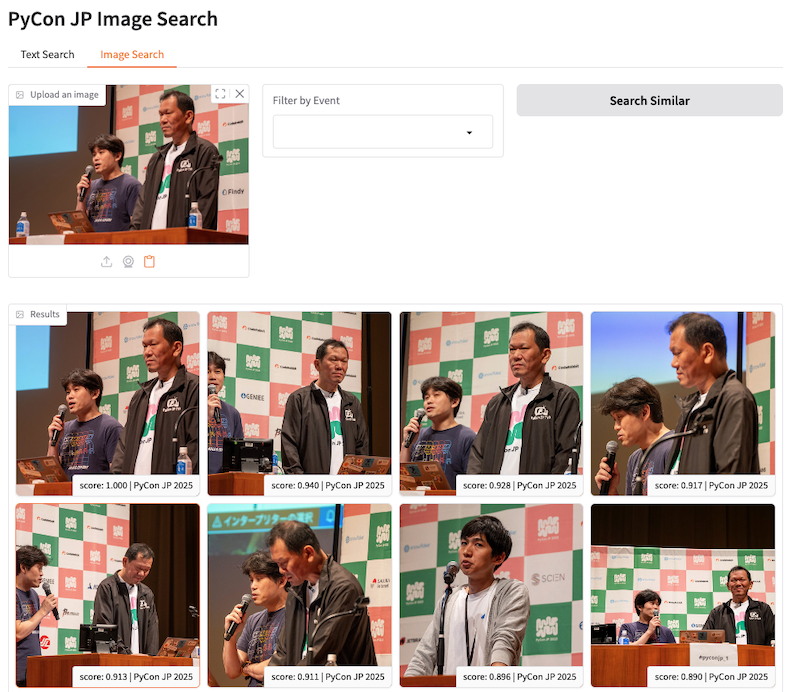
実際に触ってみて感じた点は以下の通りです。
また、過去のイベント写真を眺めていると、個人的に懐かしい写真にも予期せず出会うことがあり、技術的な検証以上の感慨深さがありました。
本検証で使用した写真データについて、以下の通り付記します。 - 使用した写真は CC-BY PyCon JP のライセンス下で公開されているものです。 - 筆者(寺田)は一般社団法人PyCon JP Associationの理事を務めておりますが、写真の取得にあたっては他の理事の許可を得た上でAPIキーを取得し、実施しました。
新しいプロジェクトとして、画像のベクトル検索を検証する Image Vector PoC を開始しました。
この実験的なプロジェクトでは、昨今のマルチモーダルモデルの進化を受けて、画像のベクトル化による検索システムがどこまで実用的かを検証します。特に、自然言語(日本語)で「どのような画像か」を説明することで、意図した画像を見つけ出せるかどうかに焦点を当てています。
現在、いくつかのモデルを比較検討していますが、日本語での検索においては Google SigLIP が比較的意図に近い結果を返す傾向が見られています。
まずはこの SigLIP を使用したシンプルな画像検索システムをサンプルとして構築し、実際の検索精度や使い勝手を確認していく予定です。
リポジトリはこちら: https://github.com/cmscom/image-vector-poc
今回は、現在開発・メンテナンスを行っている OSS プロジェクト net-vis について紹介します。
JupyterLab 上で複雑なネットワーク構造(グラフ理論のグラフ)を可視化したいとき、これまでは「決定版」といえるツールがなかなか見当たらない状況でした。NetworkX 標準の nx.draw では静的な描画しか生成されず細かい確認が難しいですし、かといって多機能な可視化ライブラリを使おうとするとセットアップが面倒だったりします。
そんな「ちょうどいい」ツールがない隙間を埋めるために開発したのが net-vis です。
CMScom Labの2つ目の記事として、現在進行中のLSH Cascade PoCについて紹介します。 1月の最終週に集中的に実験を行い、良い成果が得られたため、その概要をまとめます。